Jev-X · 模型与应用
LLM 与 JEV:从生成答案到软件决策
六张图,理解生成式模型与决策模型的区别,以及它们怎样一起工作。
· 配图解读
我们已经习惯让 AI 写文章、解释问题、生成代码。把 AI 接进一个持续运行的软件流程时,还会遇到另一类需求:这条内容该归入哪一类?这个请求应交给谁?信息不足时,系统应该继续还是等待?
这些问题,让我开始关注 JEV。它把模型的判断变成程序可以使用的选项、评分和概率。LLM 与 JEV 的区别,也因此值得从实际任务出发来理解。
本文中的 LLM 指通用生成式大语言模型,JEV 则指 TypeSafe 的具体决策模型。这个比较关注它们的设计目标和应用方式;不同 LLM 的能力、接口与性能也会有所不同。
本文的六个问题
01 · AI 给出答案后,软件如何行动?
假设你每天都要阅读大量关于 AI 的帖子。你可以让模型把这些内容总结成一段文字,帮助自己快速理解当天发生了什么。这是一个生成任务,最终结果主要由人阅读。
如果你要做一个自动更新的信息网站,需求就更具体了:哪些帖子相关?哪些属于教程?哪些提供了值得保存的数据?程序需要拿到明确结果,才能把内容放进不同栏目,或者决定展示顺序。
前一种需求重视表达与综合,后一种需求重视判断与执行。两者可能使用同一个模型,也可以由不同模型承担。理解这一点,才能看清 JEV 希望进入的应用位置。
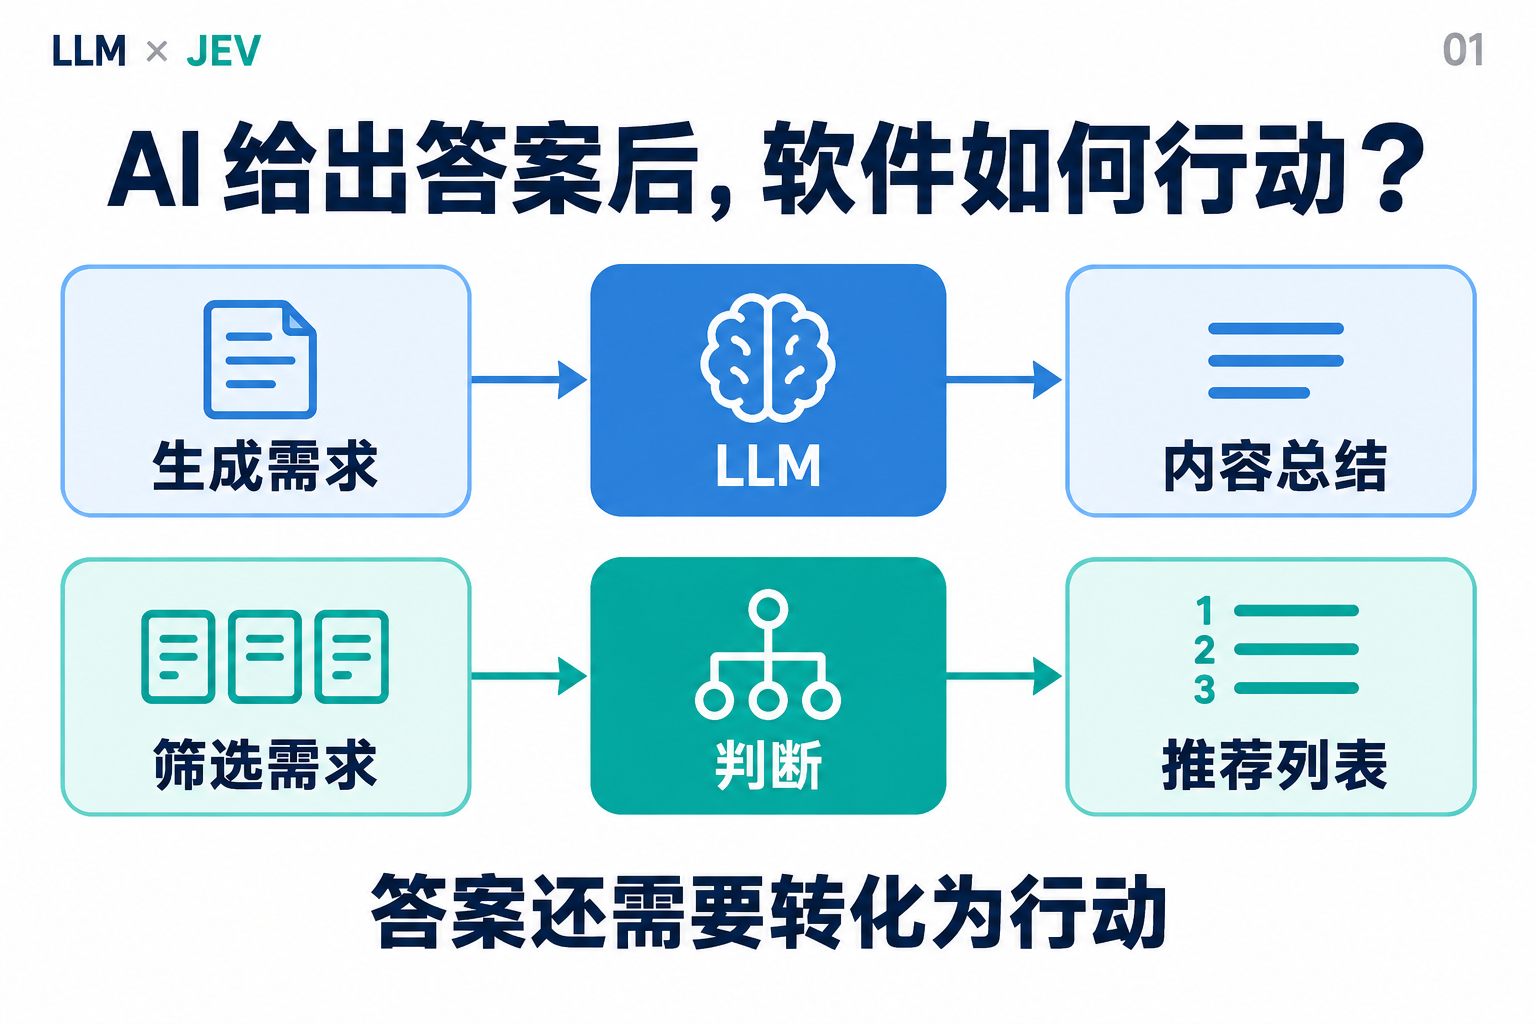
生成内容与筛选内容,对模型结果有不同要求。 查看大图 ↗
02 · LLM:灵活的生成与推理能力
LLM 的价值在于灵活。给它问题和上下文,它可以组织文字、解释概念、生成代码,也可以围绕一个开放问题提出思路。当我们还没有确定答案应该长什么样时,这种能力尤其有用。
LLM 同样可以分类、返回结构化结果,并通过工具参与软件流程。Anthropic 在《Building Effective Agents》中讨论的任务路由,就是先对输入进行分类,再交给适合的后续步骤。[2]
灵活性也带来了评估要求:文字是否准确?代码是否通过检查?工具是否真的完成了任务?Simon Willison 在对 LLM 的回顾中强调了实际评估的重要性,也提醒读者理解模型的能力与局限。[1]对于一个产品,演示成功之后,还需要检查它能否稳定处理真实输入。
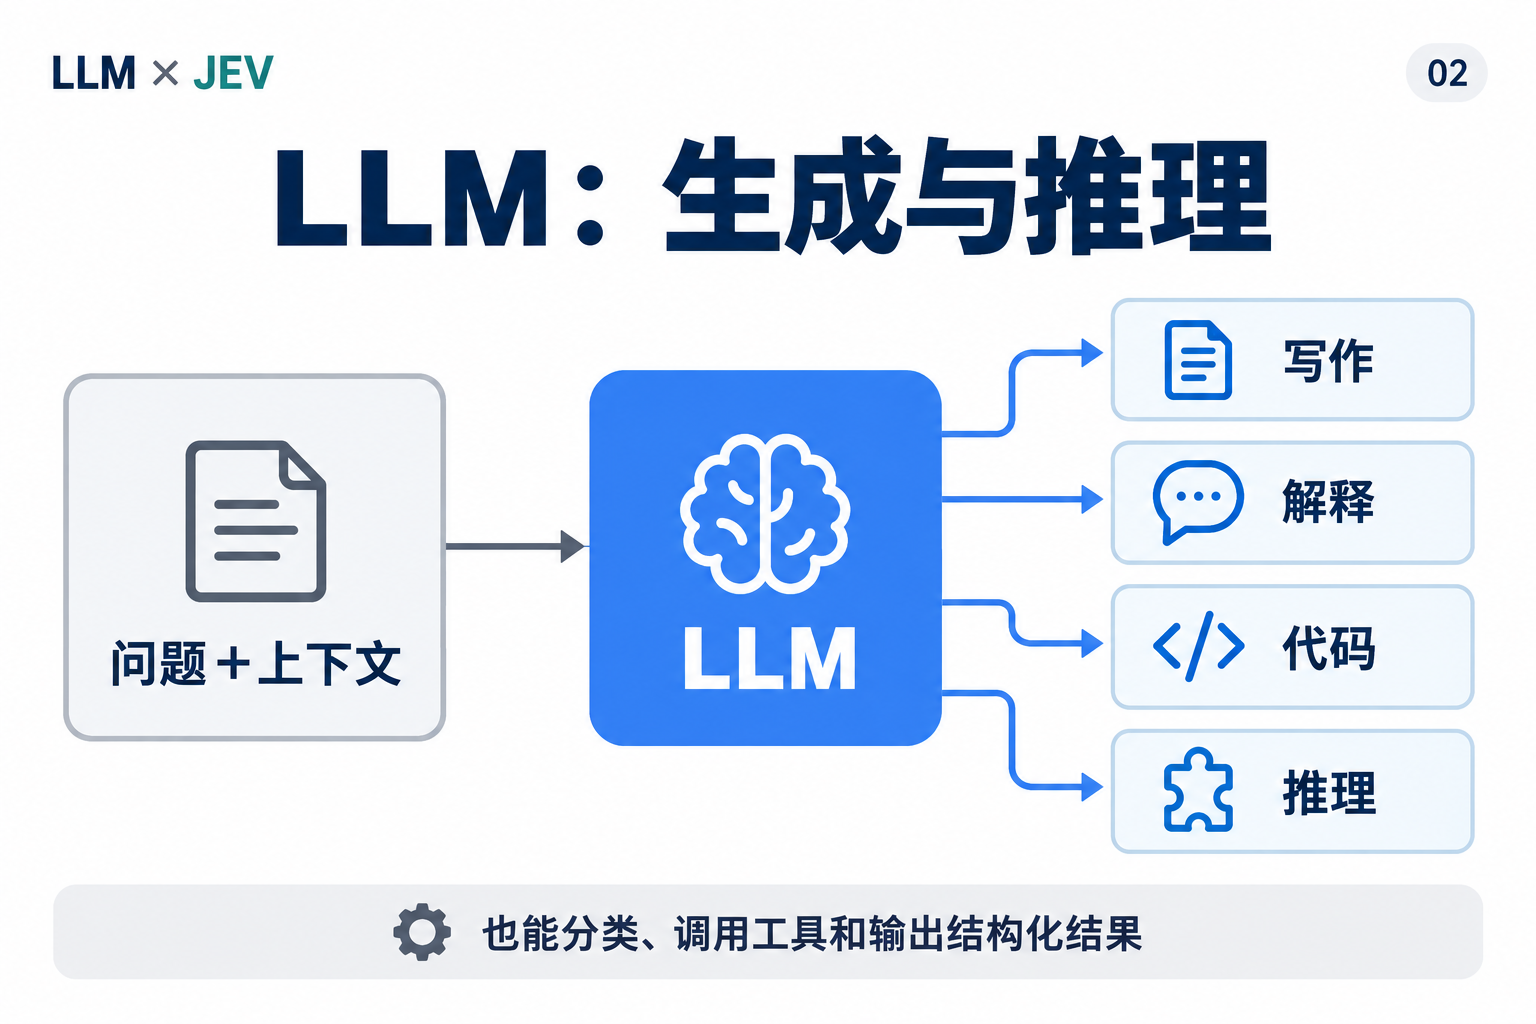
LLM 提供广泛的生成能力,也可以承担有明确边界的判断。 查看大图 ↗
03 · JEV:面向软件的结构化判断
按照 TypeSafe 的官方定义,JEV 是它的 System One 模型。调用时提供当前状态和有明确类型的问题,模型返回程序可以直接使用的判断结果,不生成自由文本。[3]
三个基础类型很容易通过例子理解:Choice 从给定选项中做选择,例如判断一条帖子属于资讯、教程还是案例;Score 按定义好的标准评分,例如评估信息价值;Noul 返回一个陈述为真的概率,例如判断帖子是否主要讨论 JEV。
它的使用方式要求开发者先想清楚问题、选项和评分标准。拿到结果之后,程序负责筛选、排序和分支处理。一个好用的决策接口,仍然需要一个清楚的任务定义。
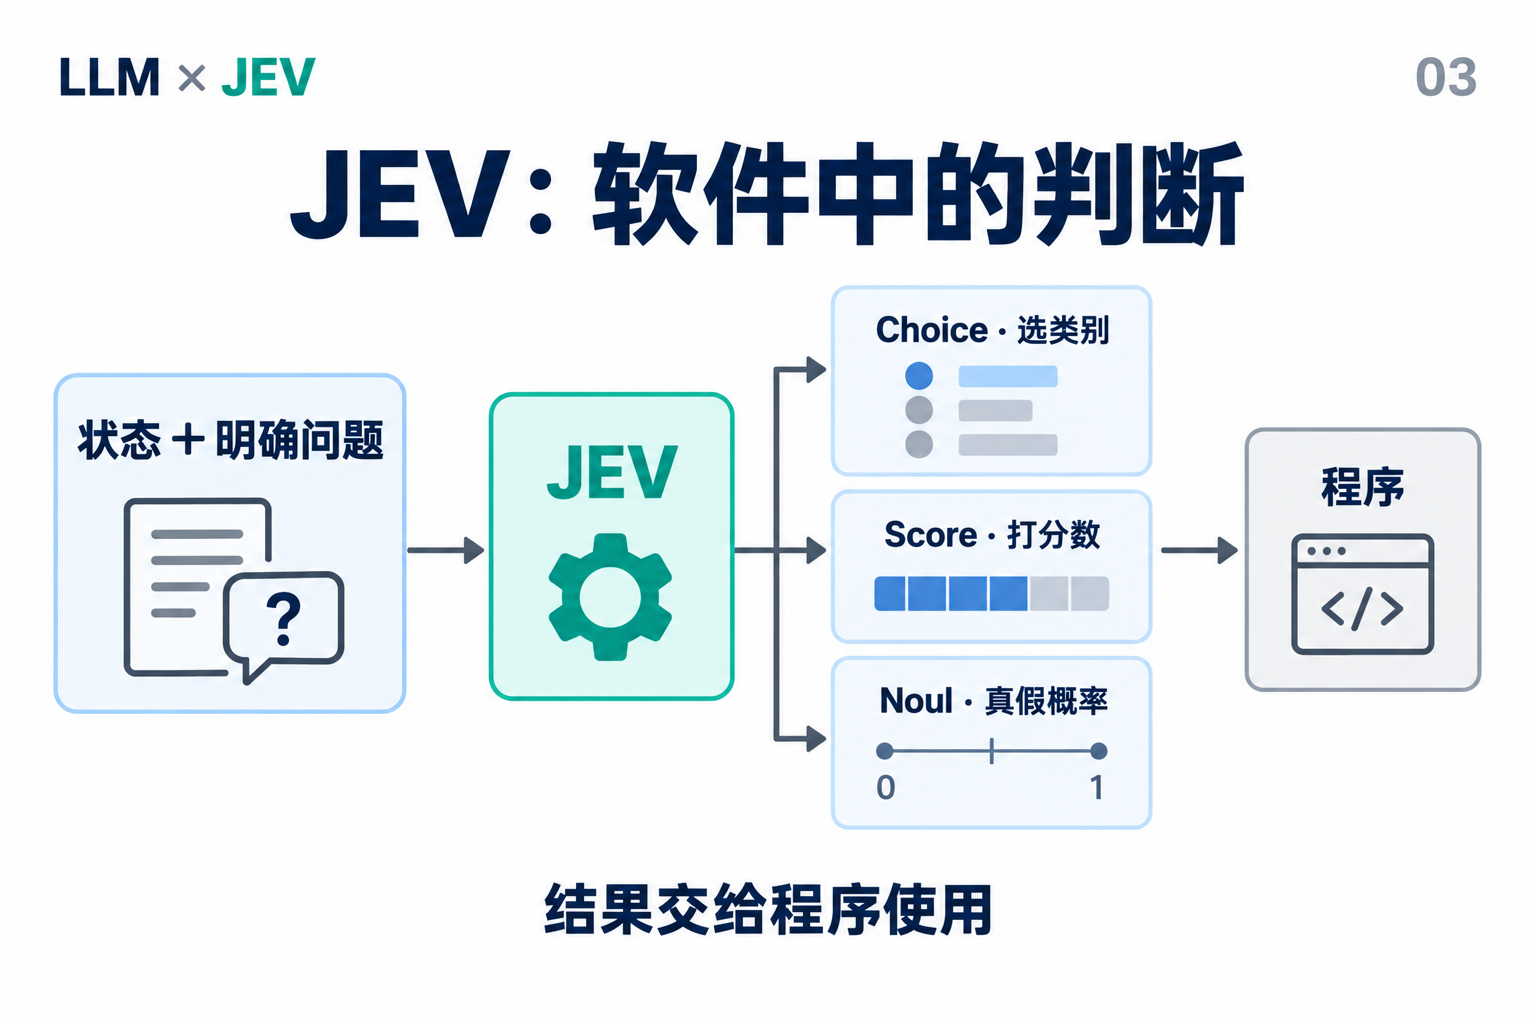
JEV 提供判断,程序决定怎样使用结果。 查看大图 ↗
04 · 既然 LLM 也能输出 JSON,区别在哪里?
这是对比中需要认真回答的问题。LLM 已经能够完成分类和结构化输出;JEV 则把有类型的决策作为专门的接口与训练目标。TypeSafe 将其训练方法称为 RLCD,即面向校准决策的强化学习。[4]
因此,比较时可以分别看任务适配、结果形式和评估方式。使用同一批输入、同一套类别与评分标准,才有可能判断一个模型是否更适合当前流程。
两种设计方向的对照(窄屏可左右滑动)
| 维度 | 通用生成式 LLM | JEV |
|---|---|---|
| 任务 | 生成、解释、推理,也能分类 | 聚焦明确的分类、评分与路由判断 |
| 输出 | 文本,也可通过结构化接口返回结果 | 限定类型的选项、评分和概率 |
| 不确定性 | 取决于模型、接口及评估方法 | 提供概率;Choice、Score 还提供置信度 |
| 性能 | 按具体任务评估正确率、延迟和成本 | 同样需要在具体任务中实测 |
TypeSafe 的发布文章展示了速度与成本方面的比较,也说明了测试条件与可能存在的偏差。[4]这些结果值得关注;放到自己的产品里,还需要计入实际输入长度、请求次数、网络延迟,以及误判后补救的成本。
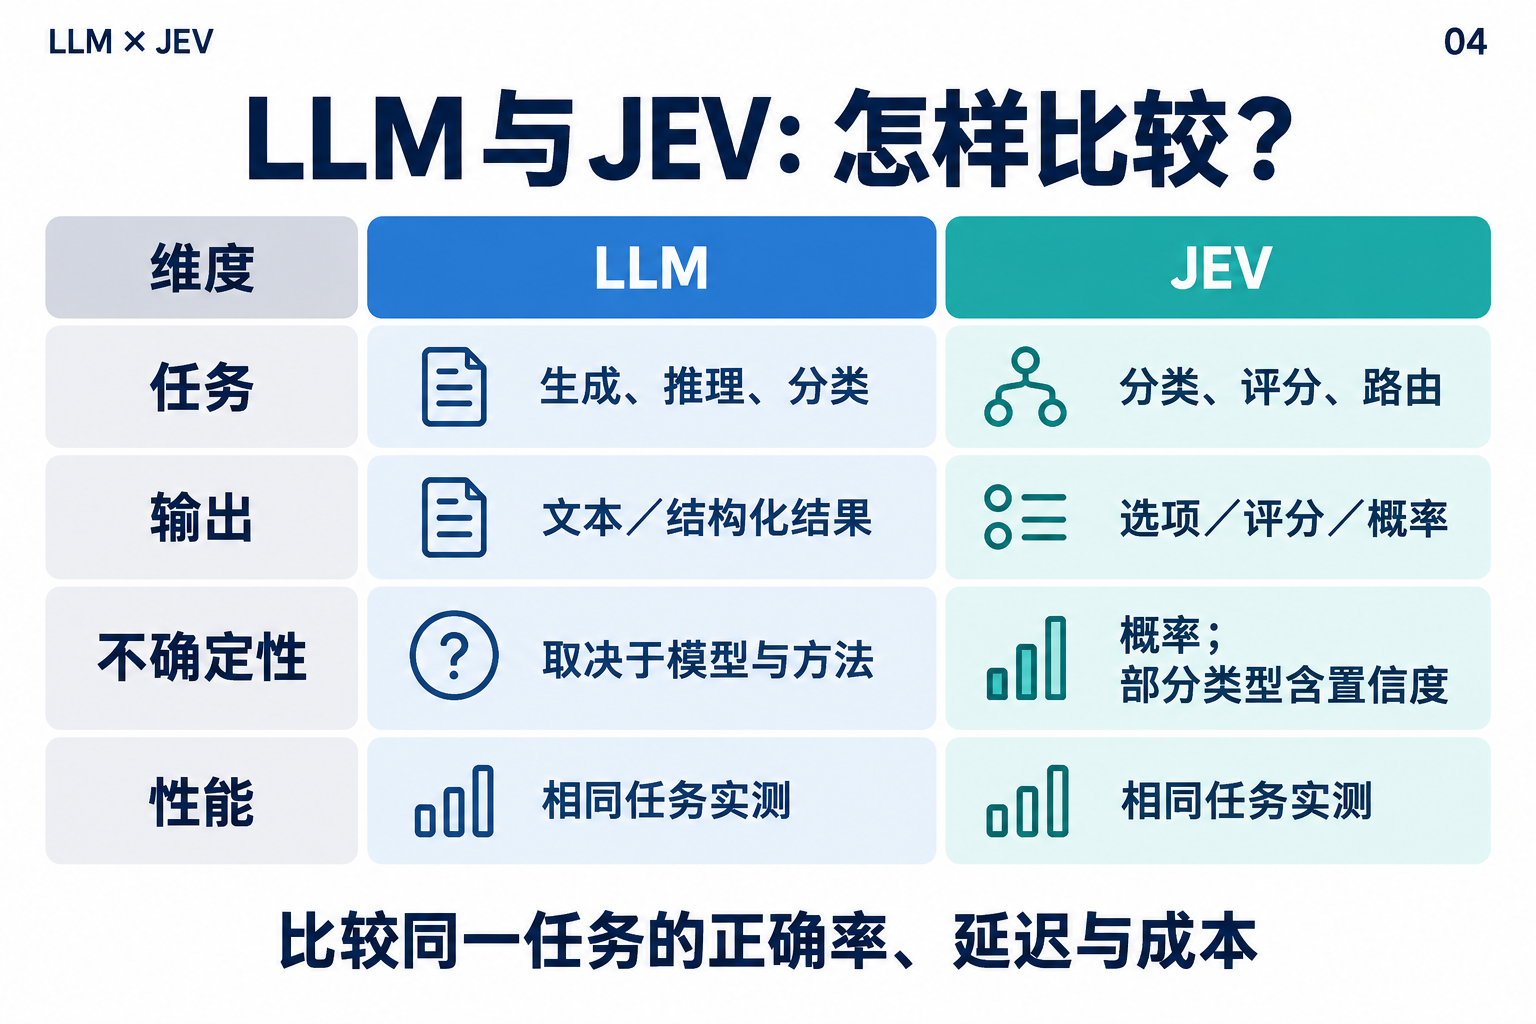
接口特点帮助选型,真实任务的表现决定是否合适。 查看大图 ↗
05 · 格式正确,判断仍然可能错误
一个结果可以完全符合规定格式,却选错类别。模型也可能给出了合理的判断,但系统在不合适的时机执行了动作。理解可靠性时,需要分别检查:格式是否正确、判断是否可信、行动是否合适。
JEV 的 Choice 和 Score 返回概率分布与置信度;Noul 返回真假概率。按照官方说明,置信度是根据概率分布的形状计算的指标,反映模型的判断有多集中。[5]它提供了处理不确定性的信号,但一个高置信度数值,仍然需要真实结果来检验。
概率是否校准,可以用一个简单问题理解:在大量相似样本中,被预测为大约 80% 概率的事件,实际是否接近 80% 发生?这需要数据验证,不能只看某一次回答。置信度指标也不能直接当作答对的概率。
在系统设计中,可以根据验证结果和误判代价,选择自动处理、人工复核或暂缓行动。不同任务需要不同门槛。这些处理策略适用于 LLM,也适用于 JEV;模型接口并不替代业务规则和权限检查。
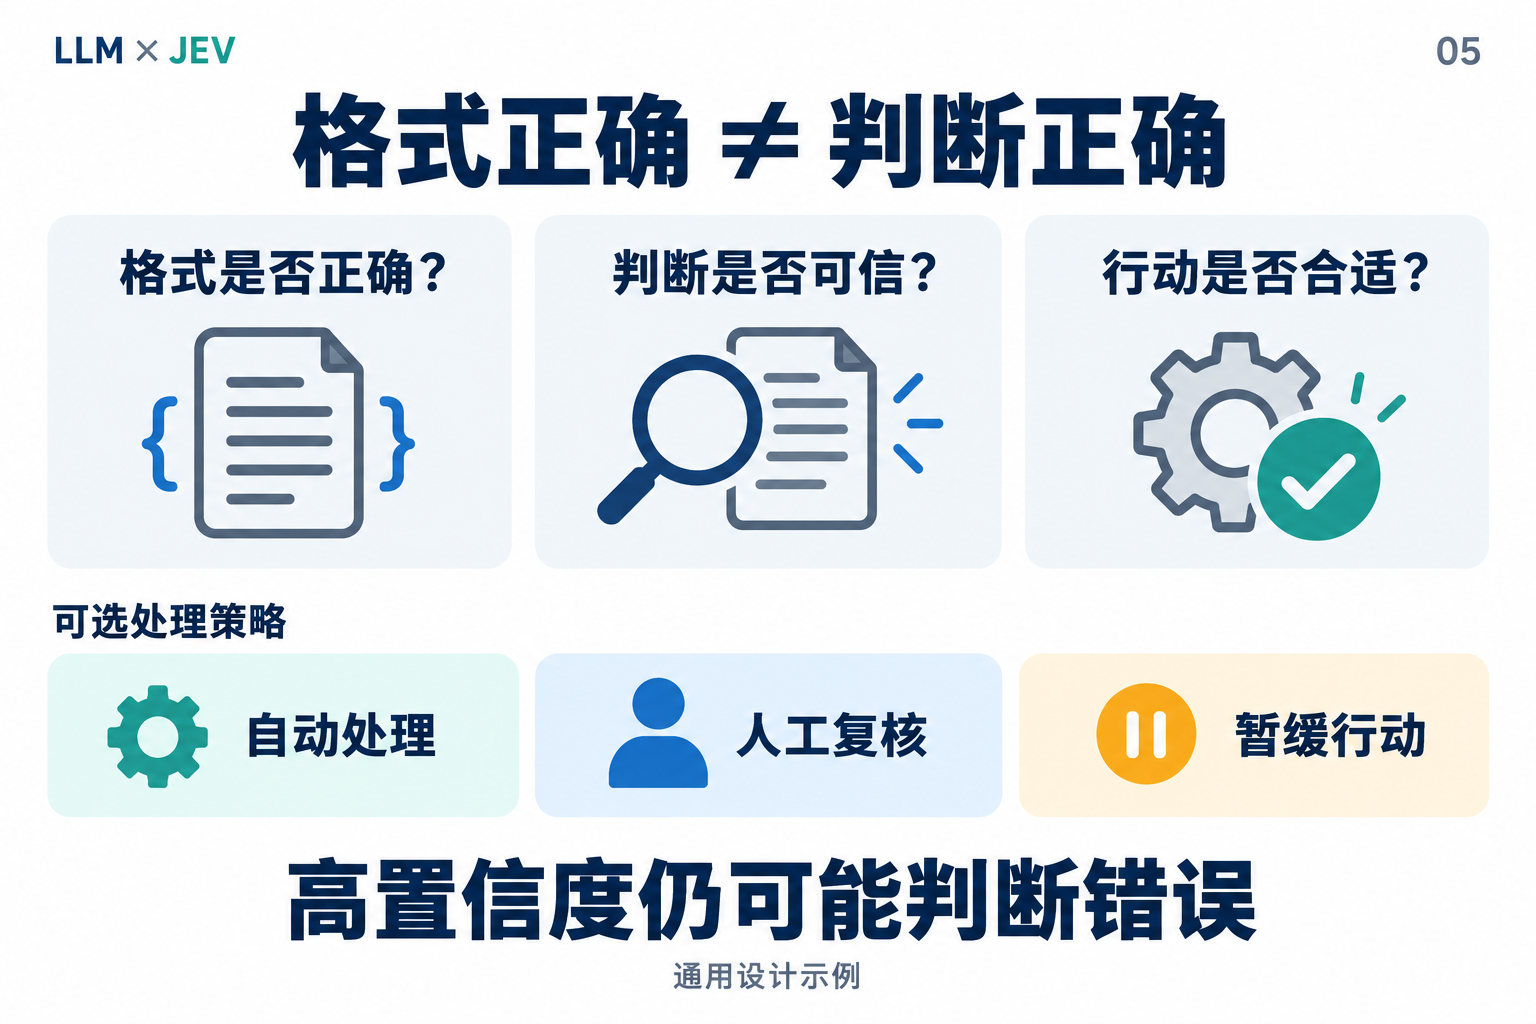
通用设计示例:根据任务证据与风险选择处理策略。 查看大图 ↗
06 · Jev-X:把内容判断接进信息流程
在 Jev-X 中,一条 X 内容进入处理流程后,程序会把正文、作者、引用内容和互动数据交给 JEV,在同一次请求里完成三个判断:它属于什么类别、是否主要讨论 JEV、对读者有多少信息价值。
分类结果用于组织内容,相关性参与筛选,质量分结合互动数据用于排序。类别置信度不足时,程序会退回关键词规则。JEV 在这里承担一个明确的判断步骤,筛选和展示仍然由程序完成。
这个例子让我更具体地理解了决策模型的价值:原本需要维护许多关键词规则的地方,可以尝试用清楚的问题和评分标准来表达。但模型依据的是传入内容;当前流程没有让它阅读外链全文或观看视频画面,评分也只是对目标读者的信息价值判断。
Jev-X 展示了 JEV 如何接入实际项目。模型准确率、概率校准程度和性能优势,仍需另做评估;这个应用本身不能证明 JEV 全面领先其他模型。
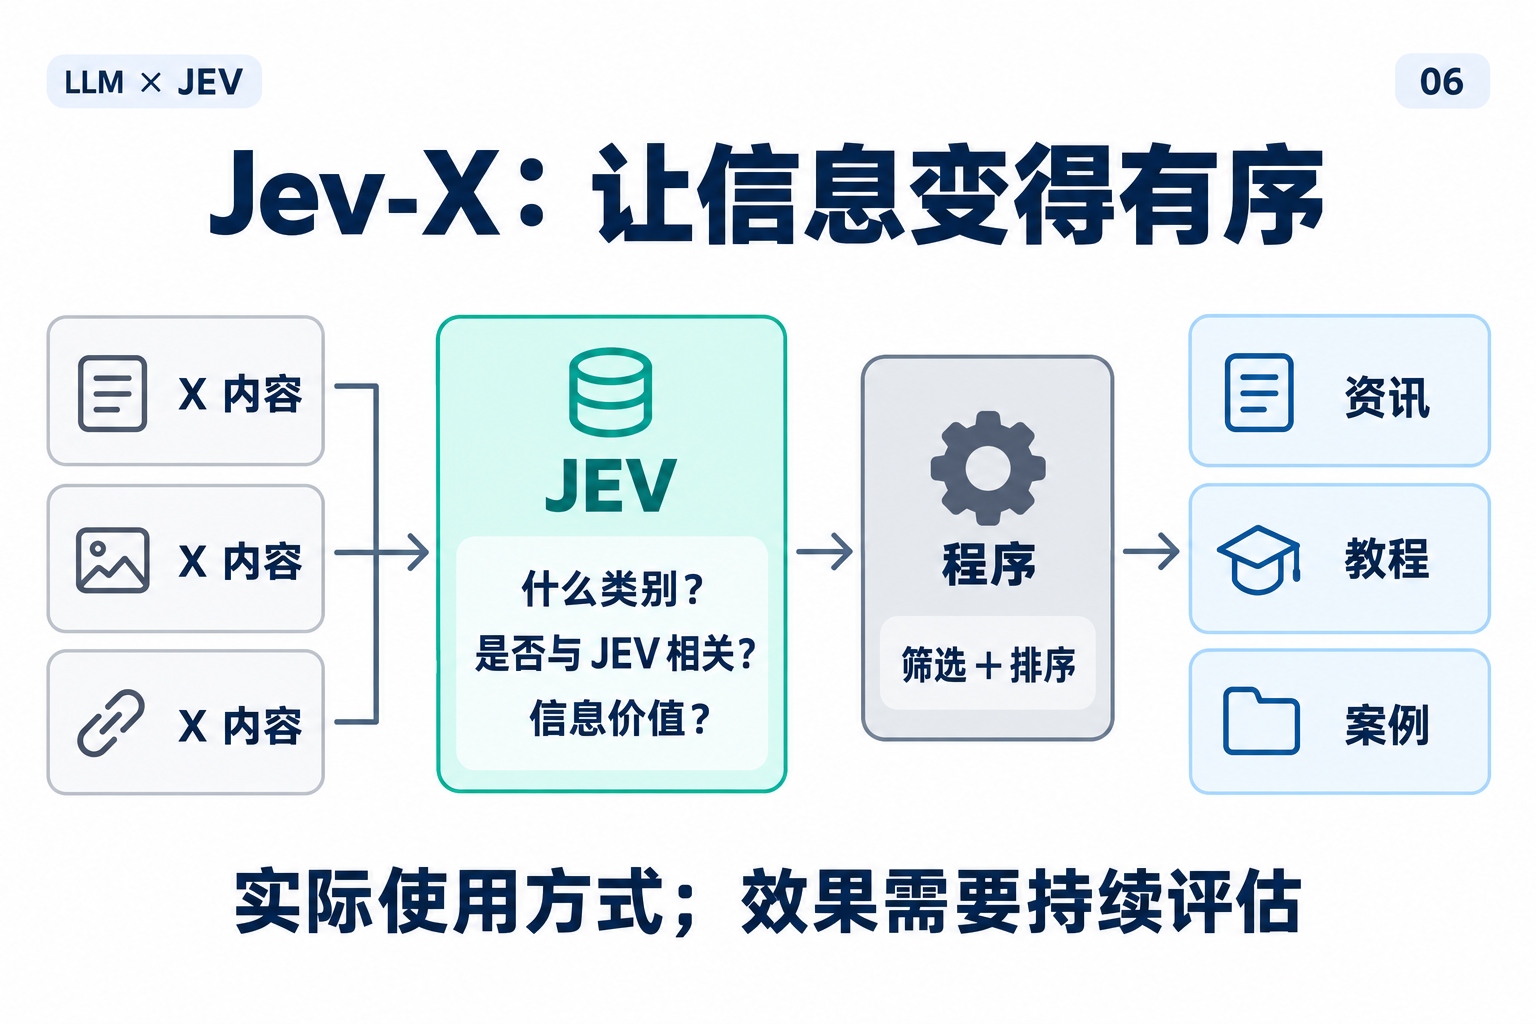
实际使用方式:JEV 判断,程序筛选、排序与展示。 查看大图 ↗
根据任务分工,用结果检验价值
需要生成、解释和开放推理时,LLM 提供了丰富的能力。需要反复完成明确的分类、评分和路由判断时,可以评估 JEV 这样的决策模型。它们也可以进入同一个流程:先判断内容与任务类型,再让适合的模型完成后续工作。
选择时,我更关心一组实际问题:判断是否准确?误判是否容易发现?人工复核量是否减少?延迟和总成本是否符合产品要求?这些结果,才会决定一种模型能否长期留在流程中。
我看好 JEV 所探索的方向,也愿意通过 Jev-X 持续观察它。把模型能力变成日常可用的一步,再用真实任务验证这一步的价值。