Jev 精选

X 上关于 Jev 的讨论,按热度排序、按质量筛选

1.4万推文
4亿浏览
15.8万回复
20.9万转发
227.9万喜欢
何笠同学
@heli8866

😱卧槽,这招的含金量,简直高到离谱!! Anthropic 最近放出了一个 Claude Code 里非常好用的方法。⬇️ 思路是让 Sonnet、Haiku 5.5、Opus 5.5 三个模型同时跑,各自只干自己最拿手的活。 效果更好,token 也省一大截,因为每个任务都交给了最合适的模型。 启动 Claude Code 时这样写就行: claude --model sonnet --advisor opus 分工是这样的: → Sonnet 5.5 负责主会话,写代码、改 bug → Haiku 5.5 在仓库里并行开工:搜索、grep、审 diff → Opus 5.5 当顾问待命,只管关键决策,最后给 diff 签字 → 不需要 Opus 的活,就别浪费 Opus 的上下文窗口 Opus 只会在三个节点出手: → 方案定下来之前 → 同一个报错出现第二次时 → 宣布完工之前 Sonnet 写,Haiku 查,Opus 审。 JEV 工程是把同样的思路再往下做一层:不用动脑的分叉(选哪份文件、选什么工具、再试一次还是停下),交给 JEV 几毫秒搞定,真正需要判断的才交给大模型。 完整结构: > Sonnet 5.5 跑主会话,统筹整体工作 > search 用 Haiku 5.5 梳理仓库,只读 > grep 用 Haiku 5.5 定位调用点,独立上下文 > audit 用 Haiku 5.5 检查 diff,在临时 worktree 里跑 > Opus 5.5 当顾问待命,签字前审一遍汇总后的 diff > JEV 在毫秒级分流各种小分叉 把这个结构连同下面这段 prompt一起贴进 Claude Code ↓ "按这个结构重新配置我的 Claude Code: 1. 主会话用 Sonnet 5.5,顾问用 Opus 5.5。 2. 在 .claude/agents 里建三个 Haiku 5.5 子代理:search(梳理仓库)、grep(定位调用点)、audit(检查 diff)。 3. 给 audit 设置 isolation: worktree,检查时不碰我的工作分支。 4. 在 CLAUDE.md 里加一条规则:所有仓库搜索和测试都交给 Haiku 5.5 子代理,让主上下文保持精简。 5. 快速、确定性的分叉(选工具、选路径、重试)交给 JEV 处理。 每处改动先用 diff 给我看,我说开始之前不要改任何文件。" 🔗: 建议收藏,以后肯定用得上。

@yakumo 在本站引用了这条
Brennan Dunn
@brennandunn

让 Jev 定期分析车库门是否开着,比真的去订购并安装一个干簧管开关便宜得多(大约每年 1.50 美元)。 Home Assistant 负责统筹,如果车库门被无意中留开,我就会收到通知。 现实版的“热狗,还是不是热狗?”

Sahil Panhotra | Indie Builder
@sahilpanhotra

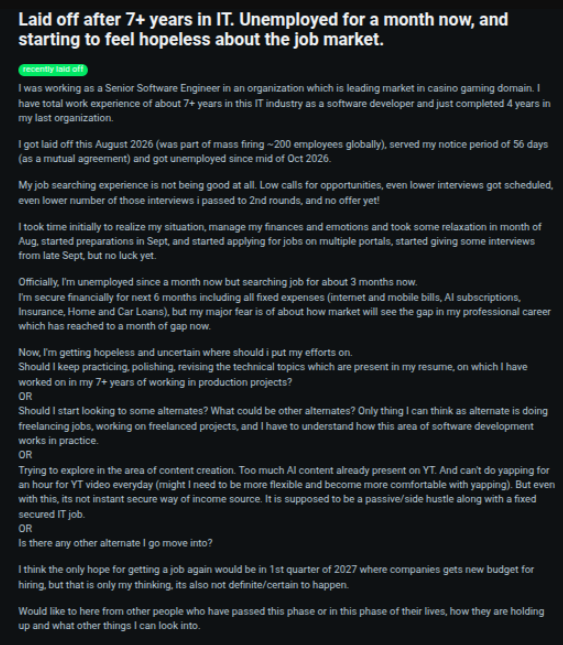
天哪,看到这样的帖子真让人沮丧。 找一份新工作不该变成另一份全职工作。 我很希望能直接把自己的技能/简历交给一个 AI 智能体,让它去找相关职位、比较薪资,并找出值得联系的人。 这件事甚至不需要订阅。完整地找一次工作,只要 $0.03。 Jev + Treg 👇

推出由 @typesafeai 驱动的 Jev jobs-api 在 treg.to/jobs-api 试用 - 一个 API 对接任何职位数据 - 运行一次完整求职只需 $0.03 - 真实薪资和招聘经理数据 - 可为任何智能体添加插件,助你找到理想工作 完全开源,零加价 代码仓库见下方 👇

Athrix ☄️
@athrix_codes

我整个找工作的过程只花了我 3.7 美分 281 个开放职位,Jev 按我的履历评分了 12 个,并给出了薪资,还告诉我该给 composio 的谁写信 找工作这事被搞定了! 给你看看:

推出 Jev @typesafeai 驱动的 jobs-api 在 treg.to/jobs-api 试用 - 一个 API 对接任意招聘数据 - 运行一次完整求职只需 $0.03 - 真实薪资与招聘经理数据 - 可为任意智能体插件化,助你找到理想工作 完全开源,零加价 代码仓库在下方 👇

Mashood K
@fromcodetocloud

别再花好几个小时在各个招聘网站之间来回跳转,去找你的下一个 DevOps 职位了。 我试用了 Treg 基于 Jev 推出的新 Jobs API,用来查找与我的技能和经验相匹配的 DevOps、平台工程、SRE 和云基础设施职位。 它帮我发现相关职位,省去了在多个平台上手动搜索的麻烦。 提示词见评论区!

推出基于 Jev @typesafeai 的 jobs-api 在 treg.to/jobs-api 试用 - 一个 API 接入任意职位数据 - 运行一次完整求职只需 0.03 美元 - 真实薪资与招聘经理数据 - 可为任意智能体插件化使用,助你找到理想工作 完全开源,零加价 Git 仓库见下方 👇

Lenny Enderle
@lenny_enderle

没人会告诉你的求职技巧:别给招聘人员写信,要写给真正负责这个职位的人。 我把网站交给我的智能体,而不是一份简历。treg 把欧洲或里斯本所有远程的开放 AI 岗位都拉了出来,jev 根据我的项目对其中 82 个进行了排序,并核查了它们实际的薪资。 然后它找到了我前三名岗位的团队负责人,验证了他们的邮箱,并起草了一封附上最匹配项目链接的邮件。未经我的允许,什么都没有发出,总共花费 $0.38。

推出 Jev @typesafeai 驱动的 jobs-api 在 treg.to/jobs-api 试用 - 一个 API 对接任意招聘数据 - 运行一次完整求职仅需 $0.03 - 真实薪资与招聘负责人数据 - 可为任何智能体添加插件,助你找到理想工作 完全开源,零加价 代码仓库见下方 👇

xsmryze
@xsmryze

这简直是个真正的金矿! Anthropic 刚刚分享了 Claude Code 最好的技巧之一。 核心思路:同时运行 Sonnet、Haiku 5.5 和 Opus 5.5,让每个模型只做它最擅长的工作。 结果更好,token 消耗也少得多,因为每项任务都交给了合适的模型。 你只需要这样启动 Claude Code: claude --model sonnet --advisor opus 分工如下: → Sonnet 5.5 负责主会话、编写代码并应用修复 → Haiku 5.5 并行地在代码仓库中“集群式”工作:搜索、grep 和 diff 审计 → Opus 5.5 作为顾问待命,处理重大决策并对 diff 进行最终签核 → 你不必再把 Opus 的上下文浪费在不需要它的工作上 Opus 只在三个时刻介入: → 计划敲定之前 → 同一个错误出现两次时 → 宣布完成之前 Sonnet 负责构建,Haiku 负责集群式处理,Opus 负责审查。 JEV 工程是同一思路的更底层版本:那些不需要“思考者”的分支决策(用哪个文件、用哪个工具、重试还是停止)交给 JEV,在毫秒内完成;大模型只处理那些真正需要分叉判断的问题。 完整结构树 > Sonnet 5.5 运行主会话并协调工作 > search 在 Haiku 5.5 上绘制代码仓库的结构图,只读 > grep 在 Haiku 5.5 的独立上下文中查找调用点 > audit 在一次性的 worktree 中用 Haiku 5.5 检查 diff > Opus 5.5 作为顾问待命,在签核前审查合并后的 diff > JEV 在毫秒内路由微型分支决策 将这棵树和下面的提示词粘贴到 Claude Code 中 ↓ “围绕这棵树重新配置我的 Claude Code 设置: 1. 以 Opus 5.5 作为顾问,在 Sonnet 5.5 上运行主会话。 2. 在 .claude/agents 中创建三个 Haiku 5.5 子代理:search(绘制仓库结构)、grep(查找调用点)、audit(检查 diff)。 3. 为 audit 设置 isolation: worktree,确保其检查永远不会触及我的工作分支。 4. 在 CLAUDE.md 中添加一条规则:将每一次仓库搜索和测试运行都委派给 Haiku 5.5 子代理,以保持主上下文精简。 5. 通过 JEV 处理快速、确定性的分支决策(工具选择、路径选择、重试)。 在我说“开始”之前,先以 diff 的形式向我展示每一项更改。在我确认之前不要进行任何编辑。” ↳ 收藏起来,以后会用得上。

rody
@0x_rody

这太疯狂了…… 这份 PDF 刚刚打破了 Grok Bot 团队的经济性。 它展示了如何在你的机器人之间的每一次交接上加一个 Jev 调用: 哪个机器人接手任务 它应该尝试多努力 该操作是否安全 草稿是否足够好 把这份 PDF 丢进你的 Grok Bot,让它围绕它重建自己的团队。 只需一个晚上,你的机器人就会运行在一个几乎没有其他人拥有的技术栈上:

Hanako
@hanakoxbt

好吧,这个 harness 太离谱了 Claude Fable 5.2 能在一个任务上同时运行 1,000 个编码智能体,而能否完成,取决于 harness 这个论点一句话就能说清:一千个智能体需要的是任务简报,而不是提示词 一份简报就是一项工作,它编辑的文件不与其他任何一项工作重叠 一个构建者交回一份回执 然后由一个陌生人来检查,这个验证者从未见过构建者的推理过程 Jev Engineering 位于这一切之上 它把每条提示路由到一个席位,在约 100 毫秒内检查 GOAL.md,并把它不确定的任何内容上报给你 删除、推送和部署操作始终会路由回你这里 所以你的工作缩减为两件事:撰写简报,批准部署 整份指南用一句话概括:给每个智能体一项工作,并配一个陌生人来检查它 然后阅读下面的文章 ↓

Artyom Shimanski
@a_shimanski

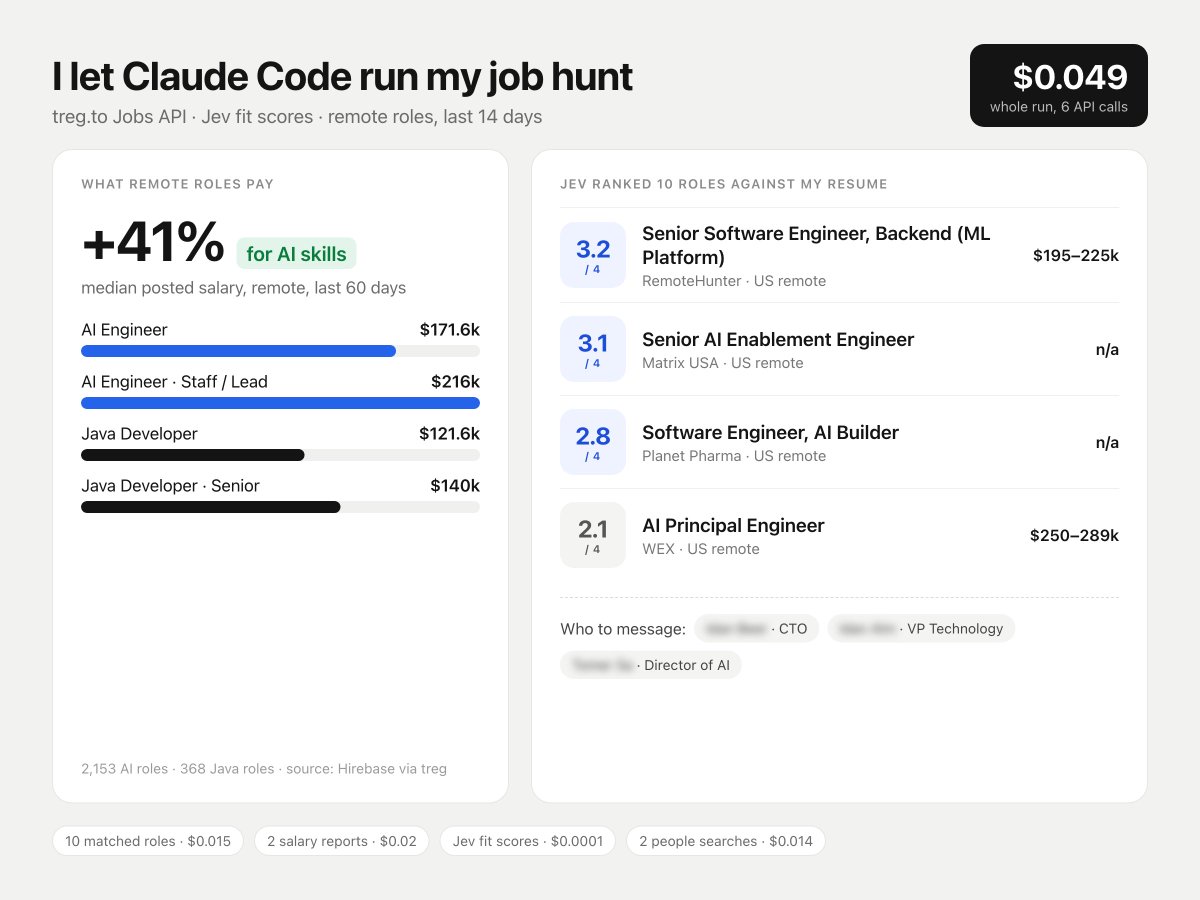
我用 Claude Code 花 0.05 美元让它帮我找工作。 它帮我: ⤷ 抓取了本周发布的远程 AI 岗位 ⤷ 用 Jev 将每个岗位与我的简历进行匹配排序 ⤷ 找到了可以私信的 CTO 和技术副总裁 ⤷ 核实了市场实际的薪资水平 最扎心的是:远程 Java 开发者的薪资中位数是 12.1 万美元 远程 AI 工程师则是 17.1 万美元 同样是我,多了 41% 👇

推出 Jev,由 @typesafeai 驱动的 jobs-api 在 treg.to/jobs-api 试用 - 一个 API 对接任意招聘数据 - 0.03 美元即可完成一次完整的求职 - 真实薪资与招聘经理数据 - 可为任何智能体接入插件,助你找到理想工作 完全开源,零加价 代码仓库见下方 👇

按分类浏览

Jev 热词

点击热词在 X 上查看最新讨论。

常见问题

关于 Jev 模型

Jev 是什么?

Jev 是 TypeSafe AI 的第一个 System One 模型,面向自动化和软件决策。它不生成对话文本,而是根据输入的状态(state)直接输出类型化的决策,并附带校准过的置信度,程序可以直接使用。训练方法叫 RLCD(Reinforcement Learning for Calibrated Decisions)。官方称在自动化任务上比常规 LLM 快 193.6 倍、成本低 444.6 倍,这些数字来自官网,本站未独立验证。

System One 模型和 ChatGPT、Claude 这类聊天大模型有什么区别?

聊天大模型擅长生成长文本和多步推理;System One 模型面向“快速判断”:给它一段内容和一个类型明确的问题,它返回选项、分数或真假判断,以及每个结果的概率。适合分类、路由、打分、审核、工具选择这类在软件里大量重复的决策。

RLCD 是什么?

RLCD 是 Reinforcement Learning for Calibrated Decisions(面向校准决策的强化学习),是 TypeSafe AI 训练 Jev 的方法。目标是让模型给出的置信度和实际正确率一致,例如置信度 90% 的判断大约九成是对的,这样程序可以按置信度决定自动执行还是交给人工。

Jev 能回答哪几类问题?

官方文档定义了三种问题原语:Choice(从一组选项里选一个,返回各选项概率和置信度)、Score(按评分标准打分,2 到 10 档)、Noul(判断一句话是否为真,返回 0 到 1 的概率)。一次请求可以同时问多个问题。

怎么开始用 Jev?

在 TypeSafe 控制台 获取 API Key,调用 POST https://api.typesafe.ai/v1/systemone,模型名写 jev-latest,详细用法见 官方文档。官方也提供 Python 和 JavaScript SDK。据 X 上的公告,Jev 也已接入 OpenRouter、Cloudflare AI Gateway 和 Vercel AI Gateway。

Jev 的价格是多少?

截至 2026 年 9 月,官方文档标注输入每百万 token 0.042 美元,输出免费,单次请求上限 64k token。价格和限额可能调整,以 官方文档 为准。

关于本站

这个网站是做什么的?

本站整理 X(Twitter)上关于 Jev 模型的优质中英文讨论:开源项目、集成、教程、实测评测、案例、访谈和资讯,并按日期统计讨论热度。本站由社区维护,策展人 @Web3wr,与 TypeSafe AI 官方没有隶属关系。

推文从哪里来?多久更新一次?

推文通过 twitterapi.io 的高级搜索接口获取,查询条件是同时提到 Jev(或 System One、RLCD)和 TypeSafe 的推文,不含转推,另加官方账号 @typesafeai 的最新推文。热门精选每小时刷新一次,按日统计由后台每 5 分钟分批抓取。

发现分类或排序不合理怎么办?

欢迎发邮件到 hello@jev-x.com,或通过 Telegram、X 私信 @Web3wr 反馈,也可以推荐遗漏的优质推文。

推文里的视频为什么有时放不出来?

视频直接从 X 的视频服务器加载,如果所在网络无法访问 X,或 X 限制了播放,卡片会提示并跳转到 X 原帖观看。

排序与数据统计

推文是怎么排序的?

每日精选和 3 天热点的排序方式不同。每日精选按 Jev 质量分从高到低排,质量分相同时新发布的在前。3 天热点仅展示最近 3 天发布的推文,纯按 X 互动分从高到低排,互动分相同时新发布的在前;质量分只用来过滤噪音,不参与排序。X 互动分参考 X 在 2023 年开源的推荐排序模型 的权重:每个赞 0.5、每次转发 1、每条回复 13.5。 热门怎么排 → 精选规则

为什么不直接按浏览量排序?

浏览量只代表曝光,大号发什么都有很多浏览;X 模型里回复权重很高,但“评论区扣 1 抽奖”这类推文会靠刷回复拿到极高的分数。所以本站不看浏览量:每日精选用 Jev 判断内容本身有没有信息量,直接按质量分排序;3 天热点按 X 互动分排序,但会先用质量分过滤掉抽奖、刷互动这类噪音(质量分低于 50 分、不及格的不展示)。

Jev 质量分是怎么打的?

每条推文和分类一起发给 Jev,用 Score 问题打 5 档分,再换算成 0 到 100:噪音(抽奖、刷互动、无关)、纯情绪、有观点、有具体信息(新闻、集成、演示、实测数字)、值得收藏(原创见解、教程、开源工具、数据)。Jev 同时会看到推文附带的文章、GitHub、视频等链接类型,以及收藏率等互动数据;大写字母式的夸张宣传不加分。 推文质量 → 精选规则

质量分会随时间变化吗?

质量分对每条推文只打一次;X 互动分每次刷新都会按最新数字重新计算,3 天热点按它排序,所以推文后来火了,排名仍会上升。

页面顶部的推文、浏览、回复、转发、喜欢是怎么统计的?

从 2026 年 9 月 15 日 Jev 发布起,逐天统计 X 上关于 Jev 的“有效讨论”,即点赞数不少于 10 的相关推文(不含转推)。数字是抓取时的快照,浏览数之后还会继续增长;0 赞的长尾推文不计入。日期和时间都按你所在的时区显示,与 X 一致:推文归入你本地的发布日期。从 2026-10-02 起按本地日期统计;此前的统计只有按 UTC 日期汇总的结果,保留原样,不重算。

内容分类与精选

推文有哪些分类?

官方(@typesafeai 发布)、集成(平台或框架接入 Jev)、开源(GitHub 项目、CLI、插件、Skills、开源复刻)、竞品(和 ChatGPT、Claude、Codex 等对比)、教程(上手、学习笔记、原理讲解)、案例(用 Jev 做出的应用和演示)、评测(实测的速度、成本、准确率)、访谈(播客、访谈、演讲)、资讯(发布、融资、用户增长)、观点(其他看法)。

分类是怎么判断的?

由 Jev 的 Choice 问题判断,每个分类都写了“属于什么、不属于什么”和真实例子。置信度不低于 50% 时采用 Jev 的结果;低于 50% 时改用关键词规则兜底。卡片上的分类标签悬停可以看到来源和置信度。

每天的精选是怎么选出来的?

每天从已分类的有效讨论中,按 Jev 质量分从高到低排序取前 50 条,质量分相同时新发布的在前;质量分低于 50 分(不及格)的不展示。当天的数据每 8 小时更新一次,一天结束后补抓一次,再过 24 小时定稿。

分享预览 · Jev-X

图片预览