Jev-X · 筛选逻辑
热度和质量,是两个维度
X 告诉我们什么正在被讨论;JEV 帮助我们判断什么值得进一步看。
· 作者 Rich
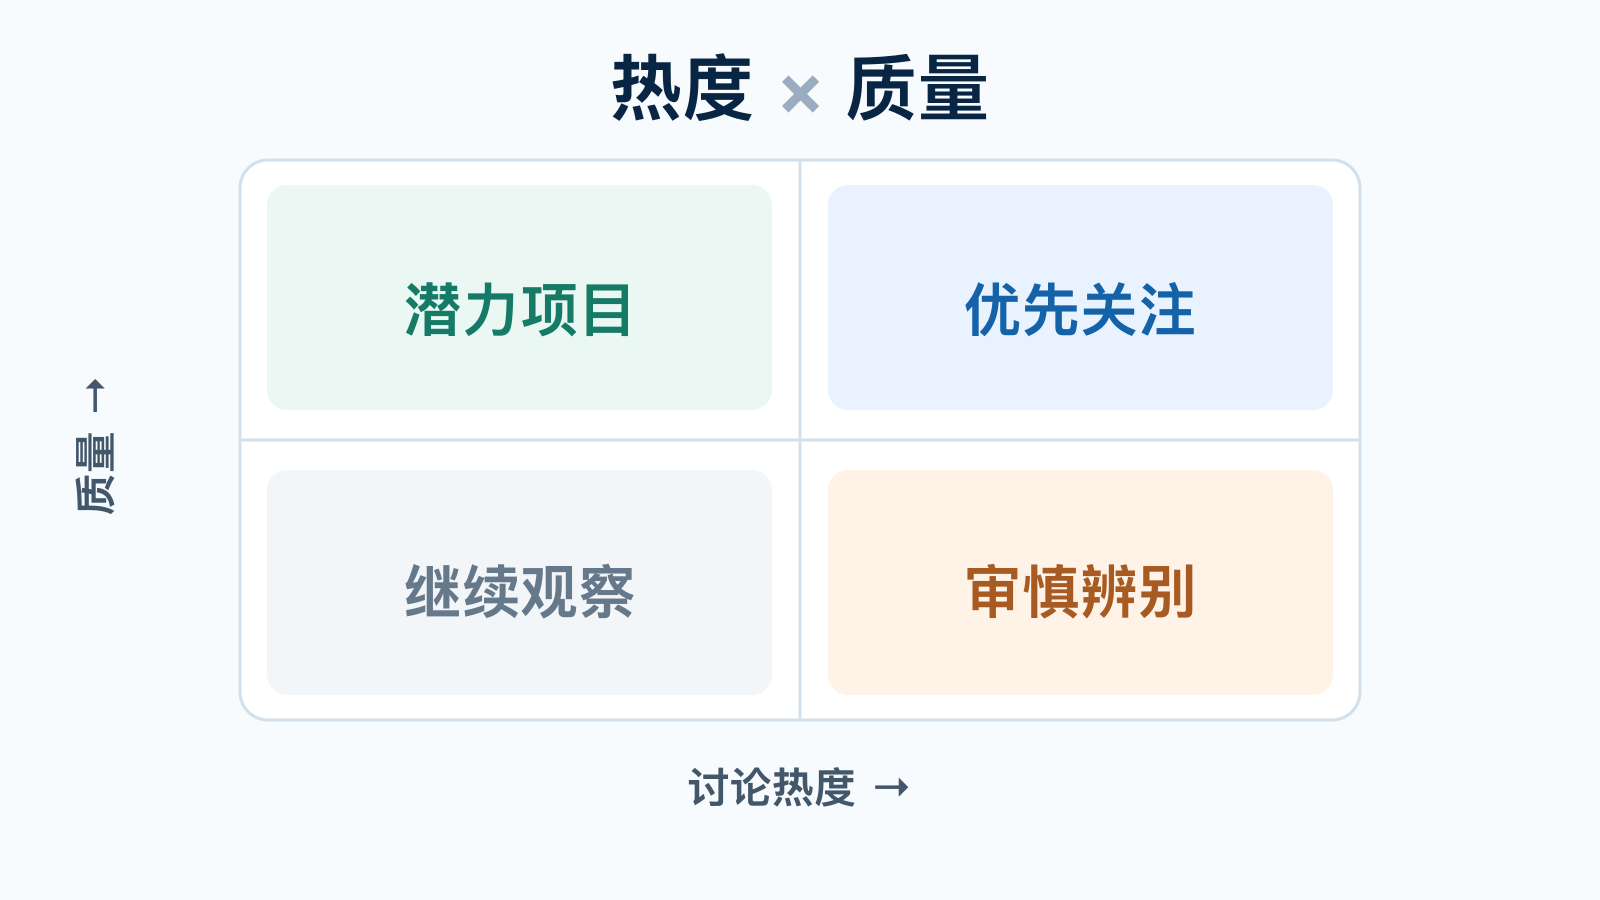
同一个项目,可以很热,也可以很好;这两件事需要分别判断。
一个新工具在 X 上被大量讨论,你可能想马上试用。另一个仓库几乎没人提,却有清楚的文档和能运行的示例。只看热度,容易错过后者;只看质量,也会失去理解社区正在关心什么的线索。
这是 Jev-X 的一条底层逻辑:热度是传播信号,质量是面向特定用途的价值判断。 两个数字回答不同问题,放在一起,读者才能决定下一步该看什么。
很多信息产品先采用热度,因为点赞、转发、回复容易计数,而逐条判断内容或项目的价值需要人读、需要时间。久而久之,容易把“被看见”当成“值得看”。热度仍然重要:它帮助我们跟上刚发生的事,也能反映社区的注意力。只是它不能独自承担质量判断。
热度:人们正在讨论什么
在截图中的项目卡片上,橙色的 X Score 来自提到该项目的 X 帖子互动。本站按每条帖子的点赞、转发和回复计算一个简化分数,再汇总到项目:
X Score = 点赞 × 0.5 + 转发 × 1 + 回复 × 13.5
例如,截图左侧第一条帖子有 190 赞、29 次转发、26 条回复,得分是 95 + 29 + 351 = 475;第二条得分 35.5,合计 510.5。它说明这些帖子产生了多少加权互动,不说明仓库能不能安装、文档是否完整,或代码是否安全。回复权重较高,争议也可能推高数字。项目榜单因此还把质量作为另一项信息展示。
质量:这个东西对谁有用
蓝色的 质量分 来自 JEV 对仓库的评估。问题被限定为“对想用 Jev 开发的人有多大用处”,分为五档:空、仅有代码、可运行 Demo、有文档可复用、成熟且持续维护。资源合集则按整理质量判断。模型获得的主要是仓库简介、README 节选、主题、语言和 Stars 等信息;它没有运行代码,也没有替读者完成安全审计。页面另列代码更新时间,但当前并未把它传给仓库质量模型,所以“成熟维护”只是评分档名,不能当作维护情况已经核实的结论。
JEV 返回五档的概率分布和 0–4 的平均档位,页面把平均档位换算为 0–100。截图右侧的 88 分 可以这样读:如果用 100 次“虚拟举手”解释模型给出的分布,五档分别约有 4、5、2、13、76 次;加权后是 (0×4 + 25×5 + 50×2 + 75×13 + 100×76) ÷ 100 = 88。虚拟举手只是解释概率的比喻,并没有真的访问 100 个人。88 分也不代表有 88% 的概率这个项目可靠。
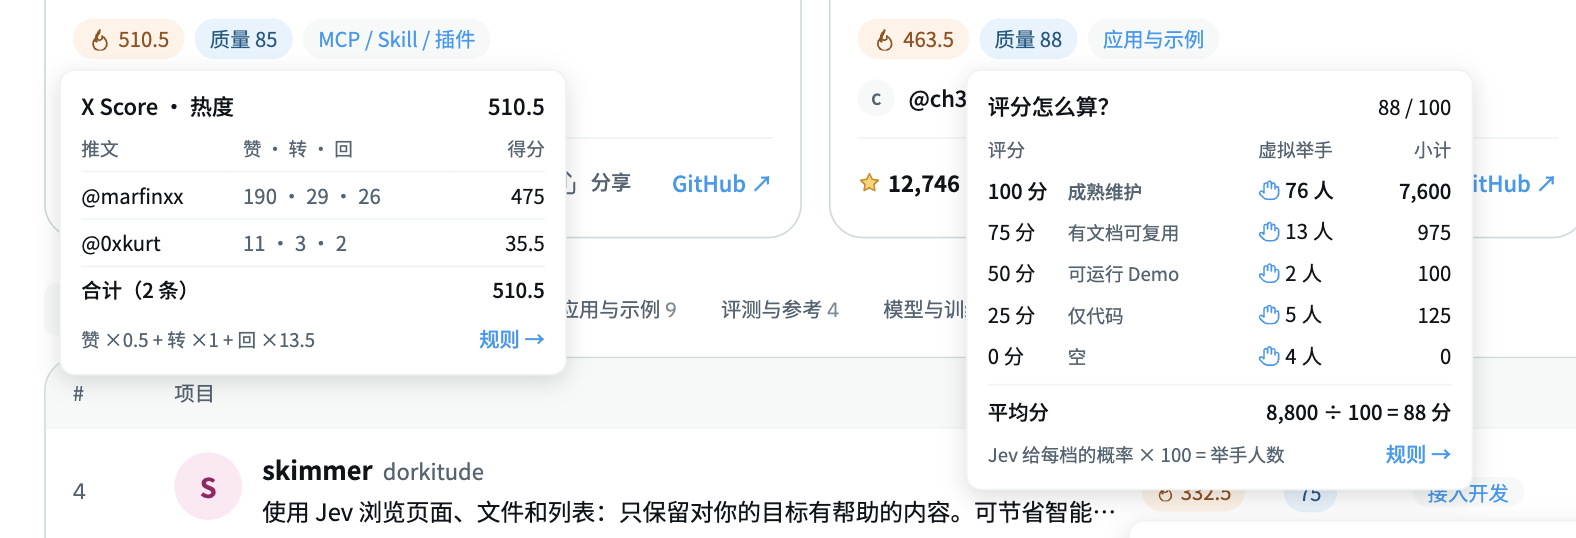
截图中的两个浮层把热度的计算来源与质量的判断依据分开呈现。
两个维度,带来四种阅读选择
| 讨论热度 | 质量判断 | 值得做的下一步 |
|---|---|---|
| 高 | 高 | 优先阅读、试用,并核对实际效果。 |
| 高 | 低 | 看清它为何被讨论;对宣传和争议保持辨别。 |
| 低 | 高 | 主动挖掘,给尚未被广泛看见的实用项目一个机会。 |
| 低 | 低 | 暂缓投入,等待更多内容或项目进展。 |
这四种情况是读者的判断框架,并非本站给项目打上的四种自动标签。当前开源榜默认按质量排序;质量相同时,再参考 Stars、讨论和代码更新时间。读者仍可以切换排序、查看来源帖子,并打开 GitHub 自己验证。
保留两个数字,还有一个实际好处:不必过早把不同目的压成一个综合分。 想知道社区今天在讨论什么,可以先看热度;想找能接入自己项目的工具,可以先看质量。遇到“高热低质”或“低热高质”,差异本身就是值得继续追问的信息。
JEV 带来的福利:把质量初筛做成日常工作
过去,要持续发现“热度低但值得用”的项目,需要有人反复读简介、翻 README、对照不同类型的项目。每多一个候选,人工时间就增加一份。JEV 让我们可以把同一个明确的问题和五档标准反复用于候选仓库,先给出可检查的初步判断,再把人的精力留给试用、核实和边界案例。
低成本使这种判断有机会覆盖长尾,而不只覆盖最热的几个项目。作为量级参考,截至 2026 年 10 月 14 日,TypeSafe 官网标注 JEV 输入价格为每百万 tokens 0.042 美元、输出免费。[1] 如果假设一次评估使用 3,000 个输入 tokens,模型费用约为 0.000126 美元;一万次约 1.26 美元。这只是按官网标价与假设用量计算的模型费用示例,不是 Jev-X 的实测账单,也不包括数据抓取、存储和人工复核;价格可能变化。
这种成本结构改变的不是“能否给最热门的十个项目打分”,而是“能否对不断出现、尚未获得关注的候选也做一次初筛”。有了覆盖长尾的机会,榜单才更可能发现被传播速度遮住的好工具。它仍是一个待验证的产品效果,不是模型价格低就自动成立的结论。
成本低,让“先判断,再决定读什么”更容易成为持续运行的系统。但判断本身仍需校验:README 可能写得好却不能运行,最近的提交也未必证明项目可维护。遇到高分但证据薄弱、低分却显然有用的项目,应回到原仓库检查,并用这些反例改进评分标准。
热度帮助我们看到社区的注意力,质量帮助我们分配自己的注意力。JEV 在这里最有价值的地方,是把原本昂贵、零散的质量初筛,变成能对大量候选反复执行、并且可以追问依据的步骤。最终是否采用一个项目,仍要由实际需求和亲自验证决定。