Jev-X · 创建初衷
为什么我要做 Jev-X
我看好决策模型的方向,也希望让值得持续关注的 Jev 进展,更容易被发现。
我做 Jev-X,源于一个技术判断,也源于一个很实际的困扰。
一方面,我认为 Jev 所代表的决策模型方向,值得认真关注。另一方面,关于它的讨论散落在 X 的信息流里,想持续了解它的进展,需要花不少时间。
这两件事放在一起,就成了我做这个项目的起点:持续跟踪一个我看好的方向,把值得阅读的信息整理出来,分享给同样关心它的人。
我为什么关注决策模型
LLM 已经展现出很强的能力。它能写文章、解释概念、生成代码,也能帮助我们整理复杂的信息。
但使用它的时候,我们仍然会遇到一个问题:当上下文不足、判断依据不充分时,它也可能给出流畅、完整,却不准确的回答。
使用者需要继续核实,分辨哪些内容有依据,哪些只是听起来合理。答案越来越容易获得,判断答案是否可信,依然需要花费精力。
这也是我关注 Jev 的原因。
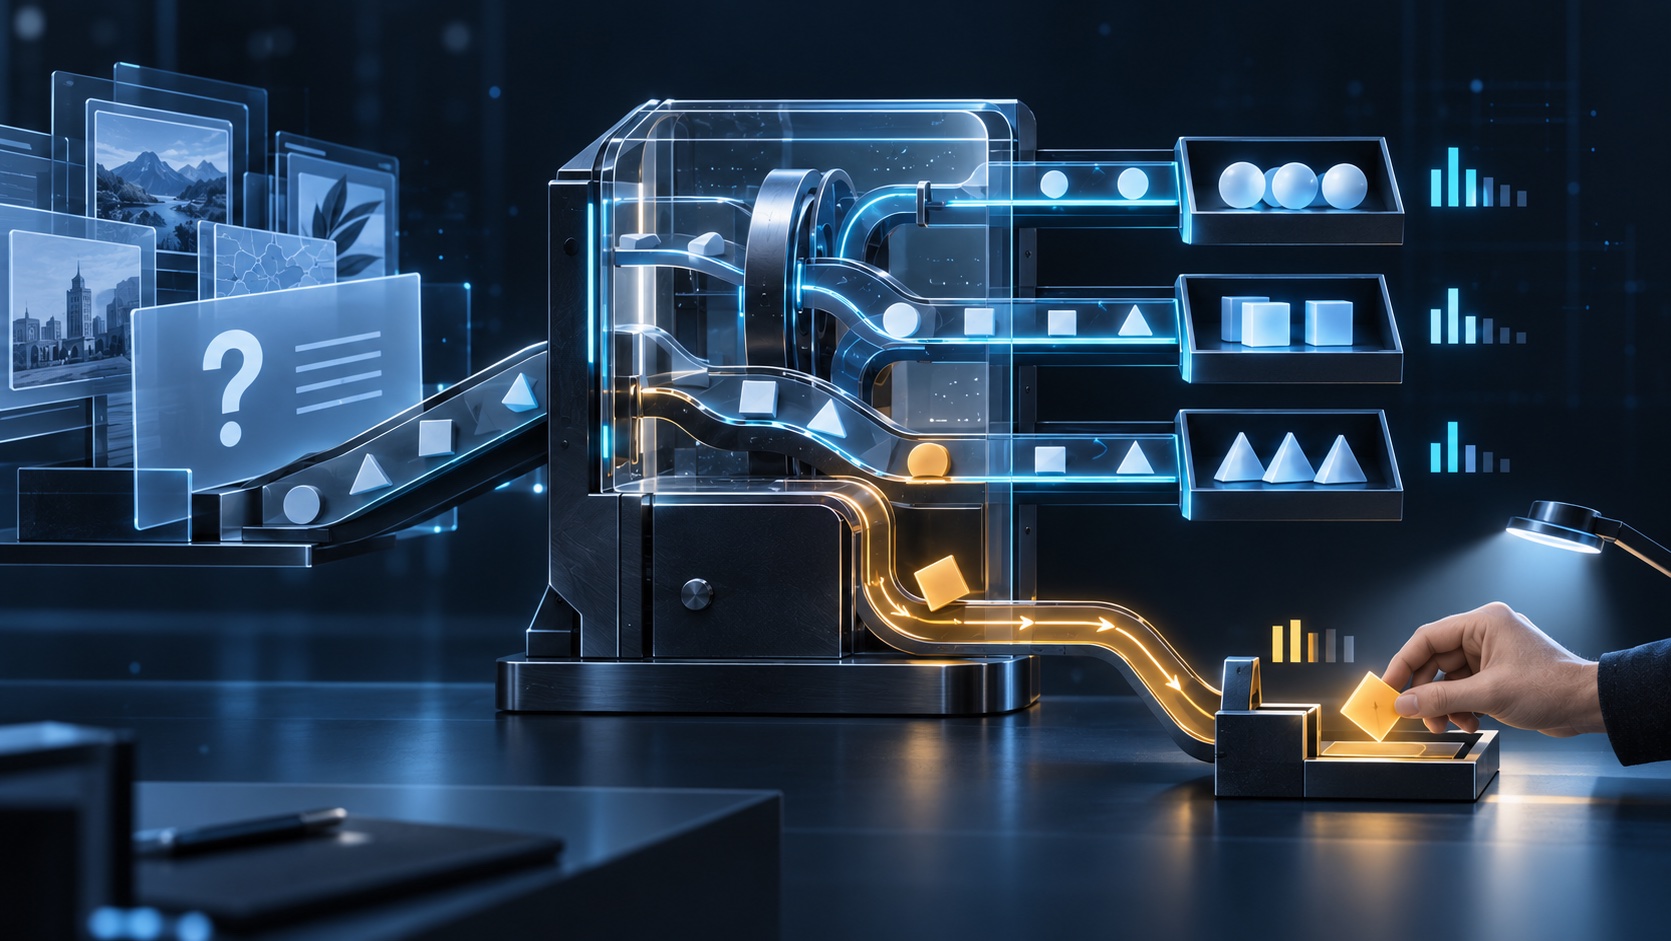
根据 TypeSafe 的介绍,Jev 面向软件中的明确判断:给它状态和问题,它返回程序可以直接使用的结构化结果,并为分类、评分等判断提供概率分布和置信度。[1]
这让我看到一种值得探索的方向:把一个判断表达清楚,也把这个判断中的不确定性表达出来,让软件有办法决定下一步该怎么做。
例如,一段内容应该归入哪一类?它有没有实际信息价值?当前结果是否足够明确,还是需要补充信息、交给人检查?
当然,结构化输出和置信度并不意味着判断永远正确。系统仍然需要结合具体任务验证效果。它们的价值在于,让不确定性成为可以被处理的信号,并据此安排不同的行为。[2]
我看好这个方向。模型的价值,可以体现在写出好的内容,也可以体现在软件每天重复执行的一个个具体判断里。
一个判断看起来很小,但当它被大量重复使用时,它的可靠性、速度和使用成本都会变得重要。随着更多开发者尝试、更多真实案例出现,我相信这一方向的潜力会逐步被理解,并在实际应用中得到检验。
我希望从现在开始,持续跟踪这个过程:关注新的尝试,也关注实际效果和能力边界。它究竟能改变什么,需要从这些具体进展中寻找答案。
为什么把它做成 Jev-X
想持续关注一个方向,很快就会遇到另一个问题:信息太多,注意力却有限。
X 上每天都有大量新内容。新产品、热点、观点和争论不断出现,很容易把我们的注意力带走。我们可能看了很多信息,却仍然错过真正关心的进展。
一次重要更新、一份认真做的评测、一个有启发的开源工具,或者一个尚未获得太多关注的应用尝试,都可能散落在信息流里。等到想重新找它时,又要花不少时间。
所以,我想做 Jev-X,把这些值得关注的内容逐步整理起来。
我希望它能帮助大家更容易找到 Jev 的重要更新、教程、开源项目、实测和应用案例,也让有信息价值的小号内容获得更多被看见的机会。
热度能帮助我们发现话题,但阅读这些内容时,我更关心它有没有带来具体信息:作者实际做了什么?结果如何?提供了哪些可供别人继续探索的线索?
持续积累这些内容,还有另一层意义:一条动态只是一个片段,把不同时间的探索联系起来,我们才能更清楚地理解,一个技术方向正在怎样发展。
从一个具体问题开始
在这个项目里,我也用 Jev 对相关讨论进行分类和信息价值评分,辅助筛选。
这是一个具体的应用尝试:把我关注的模型,用到我自己面对的信息整理问题里,再通过实际使用继续理解它的能力和边界。
评分提供的是一条参考线索。真正值得阅读的内容,仍然需要回到原文中理解。我希望整理工作能帮助大家更快找到阅读的起点,再形成自己的判断。
接下来,我会逐步改进这个项目:让分类更清楚,让有价值的内容更容易被发现,也根据实际使用中的反馈调整筛选方式。
我希望减少大家错过重要信息的机会,让我们有限的注意力,能更多地留给值得理解的进展。
这是我做 Jev-X 的起点:我看好这个方向,也愿意花时间把它的进展找出来、跟下去,分享给同样关心它的人。