Jev-X · 实践记录
JEV 在 Jev-X 中的实际应用
用一次请求完成分类与评分,再把结果接入内容筛选、排序和展示。
在做 Jev-X 的过程中,JEV 降低了我实现内容分类、评分和推荐排序的难度。
Jev-X 希望把 X 上围绕 JEV 的讨论整理起来,让读者更容易找到重要更新、教程、开源项目、评测和应用案例。抓取内容只是起点。更关键的问题是:这些内容分别在讲什么?提供了多少实际信息?哪些值得优先展示?
只靠关键词和互动数字,我需要维护许多规则,也容易遇到难以区分的情况。一条包含 GitHub 链接的帖子,可能是在发布工具,也可能只是顺带引用资料;一条获得大量回复的帖子,可能很有价值,也可能只是引发了争论。
有了 JEV,我可以把这些判断直接放进现有流程:模型提供分类和评分,程序根据结果执行筛选、排序和展示。对于当前这个内容精选项目,我因此可以用比较少的代码,完成一套可以持续运行的处理流程。
一次请求,三种判断
每条进入分类流程的内容,我会通过同一次 JEV 请求提出三个问题,分别对应 Choice、Noul 和 Score:
| 判断 | 类型 | 要解决的问题 | 程序使用的结果 |
|---|---|---|---|
| 内容分类 | Choice | 这条帖子主要在讲什么? | 类别、类别置信度 |
| 相关性 | Noul | JEV 或 TypeSafe AI 是否是内容的主角? | 相关性概率 |
| 内容质量 | Score | 对想了解 JEV 的读者而言,它有多少信息价值? | 质量评分 |
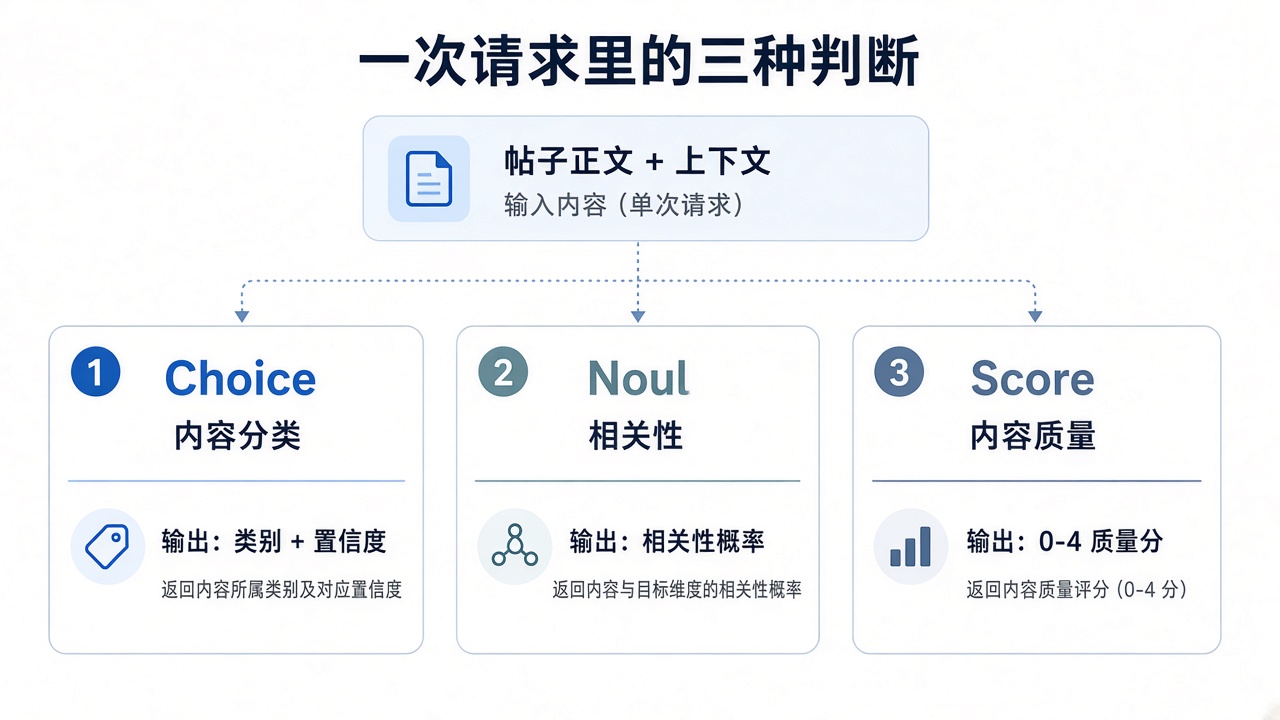
输入是内容及其上下文,输出是程序可以直接使用的结构化结果。TypeSafe 官方文档也支持在一次请求中组合这些问题。[1]
拿到类别之后,我可以生成筛选标签;拿到质量分之后,我可以决定是否进入精选,以及怎样参与排序。Prompt 是否贴合项目需要,决定了这些结果是否好用。
分类:把边界写清楚
分类 Prompt 设置了九个类别:集成、开源、竞品比较、教程、案例、评测、访谈、资讯和观点。每个类别除了名称,还写了定义、排除条件和示例。
例如,平台宣布支持 JEV,通常归入“集成”;作者展示自己用 JEV 做出的应用,通常归入“案例”;发布供别人安装使用的仓库、CLI 或插件,则更适合归入“开源”。这些内容都可能提到“用 JEV 做了什么”,但读者寻找它们的目的不同。
我要求模型按照帖子的主要目的分类。如果一条内容同时符合多个类别,就选择读者最希望用来筛选它的那个类别。
“教程”和“评测”也有明确标准。教程需要实际教会读者一些东西,或者明确介绍作者写出的指南;评测需要包含实际测试得到的数据。仅仅重复官方的速度宣传,不会因此自动成为一篇评测。
类别置信度不足时,程序会退回关键词规则。JEV 减少了需要手工维护的判断,但现有流程仍然保留了这个备用处理方式。
相关性:先记录和观察
相关性问题单独判断:帖子是在认真讨论 JEV,还是只顺带提到它、加了一个标签,甚至讨论的是同名人物或其他产品。
当前默认配置会保存这个结果,供观察和调整使用,没有把它作为强制筛选门槛。
质量:先看内容,再看互动
在质量评分上,我最重视的一条要求是:看内容实际提供了什么,而不是它听起来有多兴奋。
我没有只让模型“打一个 0 到 100 的分数”,而是先定义五档可理解的标准:
- 噪音:垃圾信息、抽奖、诱导互动或无关内容。
- 纯反应:情绪、感叹或没有信息的一句话。
- 有一定信息:带理由的观点,或者对已有事实的简短整理。
- 具体信息:真实新闻、集成进展、应用演示、实测数据或清楚的解释。
- 值得反复阅读:原创洞见、可复用方法、教程、开源工具或值得保存的数据,并有读者互动作为佐证。
JEV 按这些标准返回 0–4 的数值评分,程序再换算成页面使用的 0–100 分。它表达的是内容对目标读者的参考价值。
输入里包含哪些信息
为了给模型足够的上下文,我会把正文、作者、引用内容、外链、媒体类型和互动数据一起整理成输入。互动数据包括点赞、转发、引用、回复、收藏和浏览量,也包含计算后的互动指标。
Prompt 要求先判断内容,再把互动当作辅助证据。例如,较高的收藏比例可能说明读者愿意保存这条内容,但抽奖、“回复 1”、关注转发要求和争吵带来的互动,不应该因此获得高分。最高档也不能只靠热闹来判断。
对于介绍文章、仓库或视频的帖子,我要求模型根据正文对它们的描述判断价值。一个清楚介绍工具用途的短帖,仍然可能提供有用的信息。
当前流程没有让 JEV 阅读外链全文或观看视频画面,判断依据仍然是传入的文字和元信息。这也是理解评分时需要记住的边界。
排序:把质量分放进公式
拿到质量分之后,最终排序仍然由程序完成。目前项目使用的公式很简单:
互动分 = 点赞 × 0.5 +(转发 + 引用)+ 回复 × 13.5收藏和浏览会进入 Prompt,不直接进入上面的互动分公式。
排序分 = JEV 质量分 × log10(10 + 互动分)对互动分取对数,可以压缩热门内容在数字上的优势,让质量分在排序中发挥作用。
以两条假设内容为例:
- 质量分为 80、互动分为 100:
80 × log10(110) ≈ 163.3 - 质量分为 25、互动分为 1,000:
25 × log10(1010) ≈ 75.1
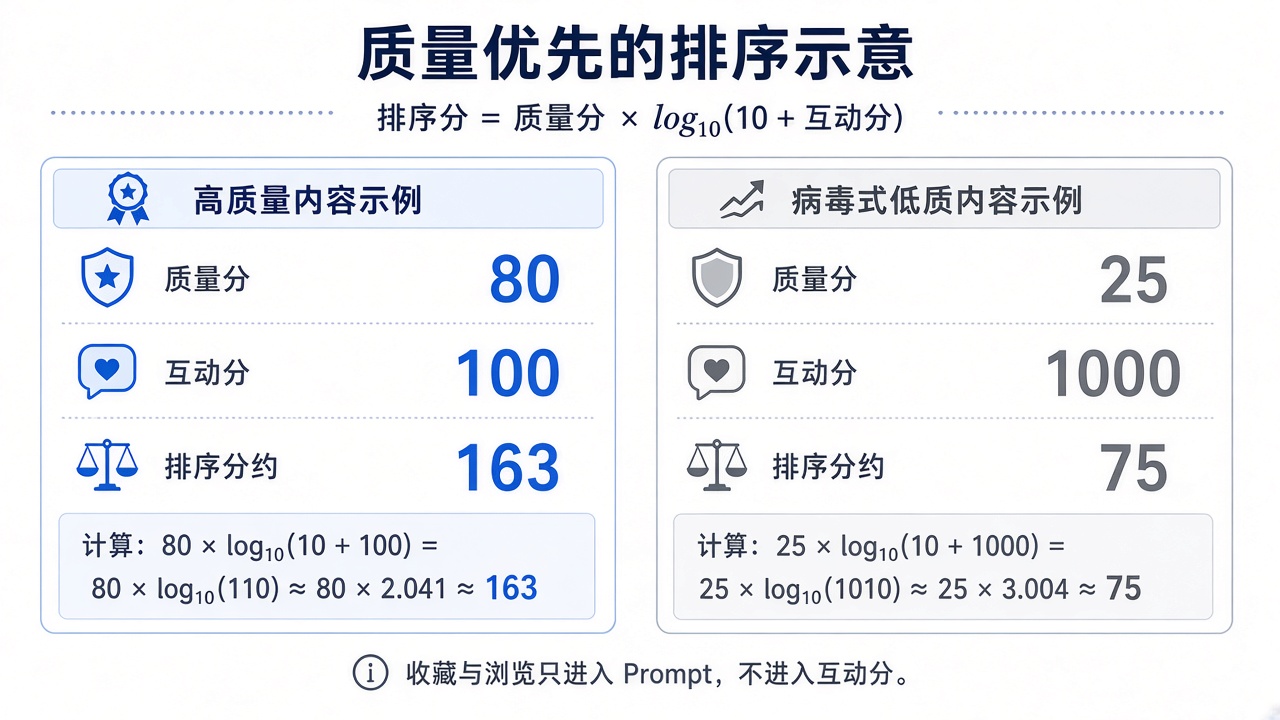
这组例子说明,质量更高的内容可以超过互动更多的内容。公式仍然同时考虑两者,不能保证所有高质量内容都一定排在高互动内容前面。
实际精选还包含互动门槛、候选数量限制、低质量过滤和同一作者的展示数量限制。这套机制服务于内容精选,没有引入用户画像或个性化推荐。
流程:从抓取到页面展示
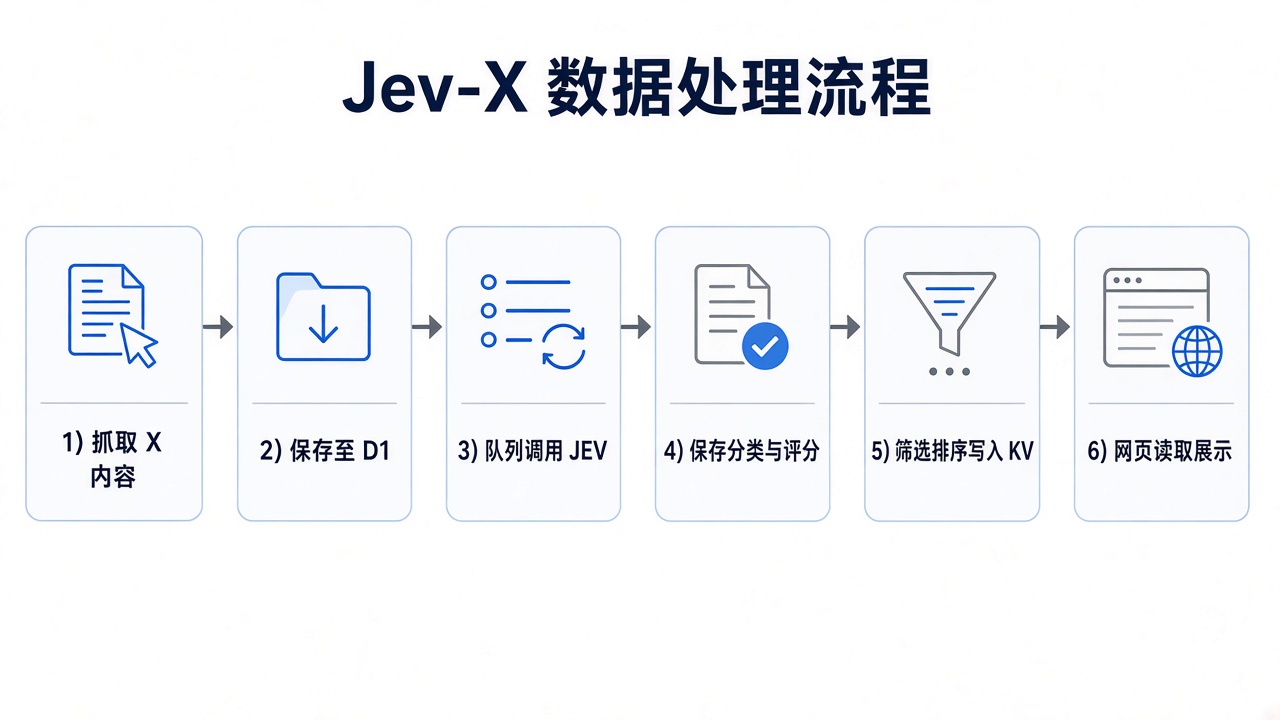
- 抓取相关 X 内容
- 保存内容至 D1
- 队列调用 JEV
- 保存分类与评分
- 筛选排序并写入 KV
- 网页读取结果
新抓取且进入分类范围的内容会登记任务。JEV 的结果保存完成后,再由后台整理和发布列表。
同一条内容如果已经有当前 Prompt 版本的完整结果,就可以复用。互动数字更新后,程序在后续发布时重新计算排序,不必每次都重新调用模型。发布失败后,也可以继续使用已经保存的判断。
网页访问直接读取整理好的结果,因此读者打开页面时,不需要等待模型现场评分。JEV 在这里承担的是一个明确、可以重复使用的判断步骤。
成本和速度
低成本是我愿意持续使用 JEV 的另一个原因。截至 2026 年 10 月 2 日,TypeSafe 官方模型文档给出的价格是每百万输入 tokens 0.042 美元,输出 tokens 免费。[2]
举一个便于理解的估算:假设一条内容连同 Prompt 共消耗 2,000 个输入 tokens,那么单次模型费用约为 0.000084 美元,处理一万条约为 0.84 美元。
这是按假设输入长度计算的示例,并非 Jev-X 的实测用量。实际费用会随正文和 Prompt 长度变化,也不包含 X 数据抓取与基础设施费用。这个量级让我可以把分类和评分放进日常处理流程。
速度同样重要。TypeSafe 的官方发布说明报告了 70–500 毫秒的端到端响应时间。[3]这是官方口径,Jev-X 尚未记录自己的延迟分布,也不能把它等同于从抓取到页面展示的总耗时。
对于需要不断重复分类和评分的项目,低成本和较短的响应时间结合起来,会直接影响这个流程是否容易长期运行。
把内容判断变成日常可用的一步
通过 Jev-X,我对 JEV 的价值有了更具体的理解:它让我更容易把内容判断写进软件。
我仍然需要定义类别、设计评分标准、处理低置信度结果,并检查实际展示效果。评分只是阅读和筛选的参考,不能替代对原文的理解。
但有了 JEV,我可以把更多精力放在产品判断上:读者需要什么信息,哪些内容值得优先出现,以及怎样让有价值的探索更容易被发现。
用较低的成本,把分类和评分变成一个日常可用的步骤,再通过简单、明确的代码,把结果组织成读者可以浏览的内容。这就是 JEV 在这个项目里带给我的实际帮助。